

はじめに
こんにちは! 株式会社BuySell Technologiesテクノロジー統括本部で、店舗買取システム「Store」のPdMをしている馬塲です。23卒として入社し、現在はプロダクトマネジメントを担当しています。
この記事では、チームで開催した業務効率化ハッカソンをきっかけに、ターミナルにこもってもPdM業務が完結する仕組みをClaude Codeで作った話を紹介します。
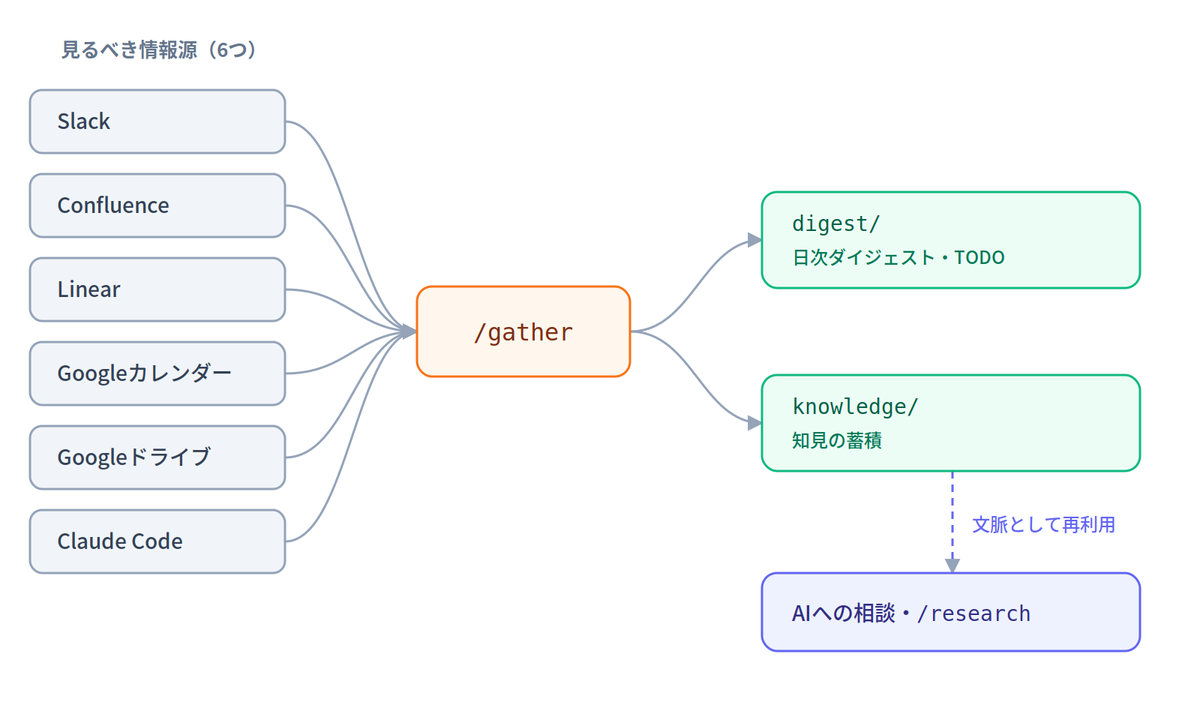
私の場合、チャット・ドキュメント・開発チケット・カレンダー・ストレージなど見るべき情報源は6つに分散しており、複数のツールを行き来しながら進めていました。
そこで作ったのが、この巡回をターミナルから一括で済ませる仕組みです。Claude Codeの「スキル」(/ から呼び出せる、あらかじめ手順を書いておく仕組み)として、PdMの定型業務を5つにまとめました。
その中心が、情報収集を担う /gather です。ターミナルでこう叩くと、
$ /gather
Claude Codeが6つの情報源をまとめて見に行き、
- 未返信のメンションや、自分が判断を止めている相談
- 開発チケットの更新と、止まっている作業
- 直近のMTGと議事メモ
- 新しく追加された資料
といった「いま把握しておくべきこと」を1枚のMarkdownに書き出し、あわせて、そこで出てきた決定事項や調べた内容をテーマ別のナレッジとして蓄積してくれます。ツールを個別に開かなくても判断に必要な材料がその場に揃い、蓄積されたナレッジは次にAIへ相談するときの文脈としてそのまま使える、という状態です。
同じ考え方で、情報収集だけでなくPRDの作成やデータ分析もスキルにしたので、日々のPdM業務のかなりの部分がターミナルの中で完結するようになりました。
AIによる自動化そのものもよかったのですが、この仕組みを作ってみて一番良かったのは、実は自分の業務を構造化できたことでした。同じように情報の巡回に時間を取られているPdMや、AIエージェントで自分の業務を効率化したい方の参考になれば幸いです。
背景と目的
きっかけは単純で、PdM業務をもっと効率化したいとずっと思っていたことです。
PdMをやっていると、見るべき情報源が分散します。私の場合は次の6つでした。
- Slack: 依頼・相談・意思決定のログ
- Confluence: PRD・仕様・議事録
- Linear: チームの開発チケットと進捗
- Googleカレンダー: MTGの予定とGeminiの議事メモ
- Googleドライブ: 資料・分析シート
- Claude Code: 自分の作業ログ
分散しているのは面倒ですが、逆に言えば、この6つを全部見ればほぼすべての情報は取れるということでもあります。ここが出発点になりました。
そのうえで、何を効率化したいのかを整理すると、目的は大きく4つに集約されました。
- 情報の見逃しをゼロにしたい(漏れなく全部把握したい)
- 知見を資産にしたい(調べたこと・決まったことを蓄積して、次に活かせる状態にしたい)
- 定型作業を自動化したい(PRD作成・効果試算・情報収集を毎回ゼロからやるのは非効率)
- 意思決定を速くしたい(必要な情報に素早くアクセスして判断材料を揃えたい)
やりたいことは前からはっきりしていたのですが、まとまった時間が取れず、なかなか仕組み化に着手できずにいました。そんなとき、チームで業務効率化のためのハッカソンを開催する機会があり、そこで一気に作り切りました。
やったこと
Claude Codeで、「ターミナルにこもっても業務が完結する」仕組みを作りました。全体像は次のとおりです。中心となる /gather が6つの情報源から情報を集め、成果物を digest/(ダイジェスト・TODO)と knowledge/(知見)に残します。蓄積した knowledge/ は、AIへの相談や /research が文脈として使い回します。
スキルは最終的に5つになりました。
- 情報収集(
/gather): 6ソースから、基本は前回の実行時刻〜現在時刻までの差分を取得し(日付の指定も可能)、ダイジェスト・TODO・知見を同時に出力する。ソースへの定期アクセスはこのスキルに集約している - リサーチ(
/research): テーマを投げると、knowledge/+ 6ソース + BigQuery + ローカル資料を横断検索する。/gatherが「今日何が起きたか」を網羅するのに対し、こちらは「特定テーマを深く掘る」(期間制限なし) - データ分析(
/bq-analysis): BigQueryのデータで、効果試算・効果検証・データ分析を行う - PRD作成(
/prd-create): 曖昧な要望を、WHY(なぜやるか)とWHAT(何を達成するか)に絞ったPRDへ構造化する(実装方法のHOWは書かない) - PRDレビュー(
/prd-review): 既存のPRDを6つの評価軸で採点し、抜け漏れを指摘する
/gather は決まった時刻に流すバッチではなく、状況を把握したいタイミングで何度でも叩けます。実行すると、こういったダイジェストが返ってきます。
実際の出力はこんなイメージです(サンプル)。
# 2026-07-28 ダイジェスト
## 18:15 巡回(前回 07-27 18:15 〜 現在の差分)

### 今日の要点
1. 🔴【要返信】◯◯さんから「この機能を先行リリースできないか」と相談。可否と工数の判断がこちらのボール
2. 定例で「△△はインシデントとして扱う」と決定。全社オペ策定は運営チームへ
3. AI査定まわりの実装がレビュー中

### Slack(メンション3件 / スレッド5件)
- #team-store ◯◯さん (12:48): 次回リファインメントは予定どおり実施でOK
- #team-crm 名寄せロジックの相談(返信9件): 発火条件は氏名/電話/住所/メールの重複…

### Linear(更新12件)
- STR-1234 sidecar API実装(レビュー中)
- STR-1240 進呈品の再作成画面(In Progress)

### TODO
- [ ] ◯◯さんへ先行リリースの可否を回答(今週中)
- [x] ~~書類データの引き出し手配~~(完了: 送付済み)

### 改善提案
- 💡 A. ◯◯さんの判断待ちが1週間経過。進捗確認を
- 🔧 B. Slackが取得上限の20件に達し2ページ目が残存。取得漏れの可能性
/gatherの出力例(サンプル)。冒頭に「今日の要点」、続いてSlack・Linear・TODO・改善提案が並びます。
もう一つ意識したのが、情報の置き場所も「探し方(動線)」で設計することです。「どんなときに探すか」でディレクトリを分けました。
./
├── digest/YYYY-MM-DD.md   ← 日次:今日何が起きたか(日付軸)
├── knowledge/テーマ名.md   ← 蓄積した知見(テーマ軸)
├── テーマ名/               ← 作業はテーマ単位(PRD/効果試算/検証など成果物・分析スクリプト)
└── 分析用/                 ← 横断的に使う分析データ・テーブル定義
「日付で思い出すもの」は digest/ に、「テーマで思い出すもの」は knowledge/ に。探すときの頭の動きに合わせて置き場所を決めています。
ビフォーアフター
導入前は、情報が6つに分散しているぶん、何かを把握したいたびに個別のツールを開いて確認していました。AIに相談するたびに背景を一から説明し直す必要があり、せっかくの調査結果や判断根拠も、会話が流れると埋もれて消えていきます。
導入後は、/gather を叩けば、必要なタイミングでその時点の全情報が手元に来るようになりました。さらに大きかったのは、knowledge/ に知見が自動で蓄積され、AIが最初から文脈を持っている状態を作れたことです。相談のたびの前置きが要らなくなり、TODOの管理もしやすくなりました。
試行錯誤① 3層構造への転換
ここからが本題です。最初、私は素直に「やりたいこと」ごとにスキルを作ろうとしました。ところが、いざ書き出してみるとやりたいことが想像以上に多く、1つずつスキルにしていったら気づけば11個に膨らんでいました。
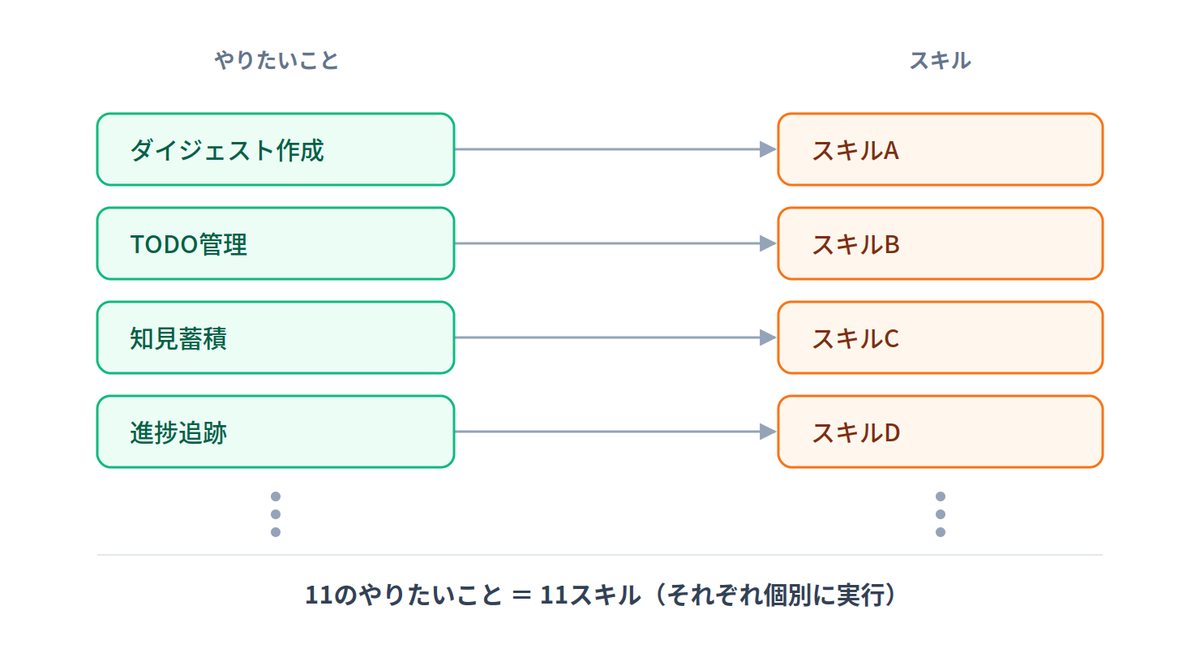
この「1やりたいこと=1スキル」方式は、3つの理由で破綻しました。
- 全部をバラバラに実行しないといけない(面倒)
- 同じソースに何度もアクセスする(token の無駄遣い)
- スキル間でデータの不整合が起きる
さらに、作っているうちに「単発の作業を1つずつ自動化する」のではなく、業務そのものを丸ごと効率化したいという気持ちが強くなってきました。スキルを1つずつ積み上げる形では、そこには届きません。
そこで、目的(なぜやるか)・やりたいこと(何を実現するか)・スキル(どう実現するか)の3層に分けて整理し直しました。
キモは、1つのスキルが複数の「やりたいこと」を同時に叶える設計にしたことです。たとえば /gather は1回の実行で、ダイジェスト・TODO・知見・進捗をまとめて出力します。次の図のように、11個の「やりたいこと」が5つのスキルに束ねられています。
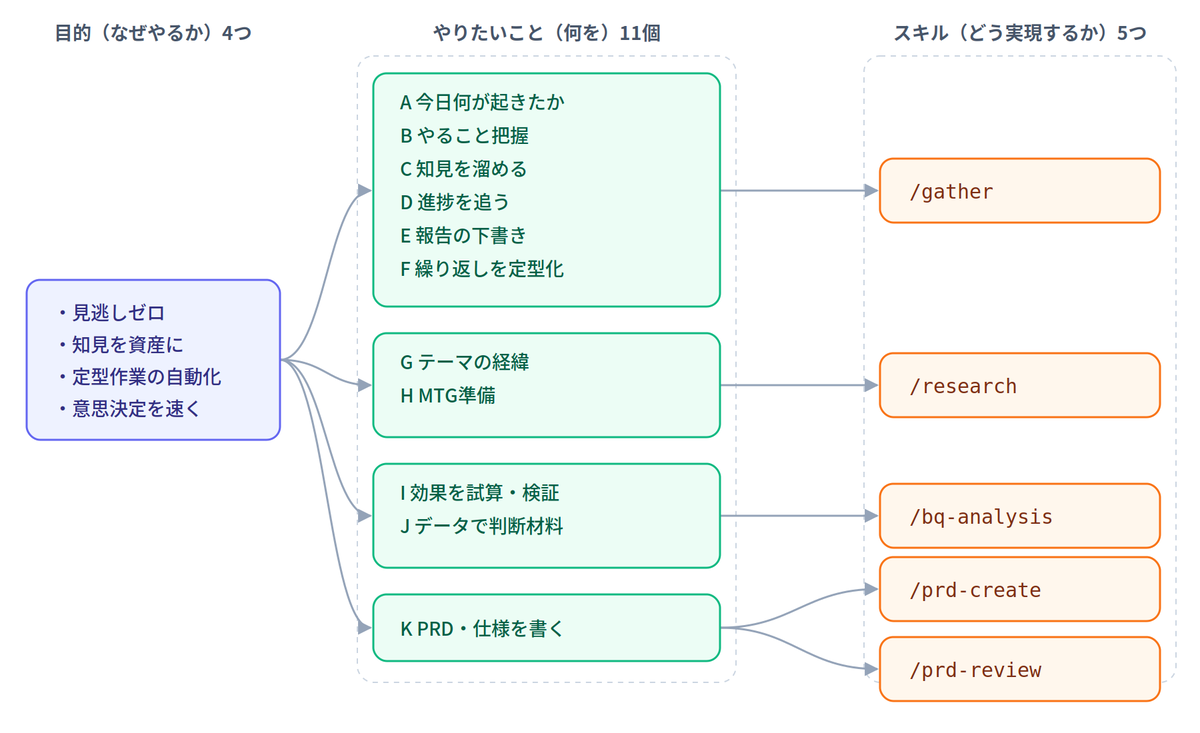
こうして 11個のやりたいことを5スキルに集約できました。大事なのは、これは実装コードの工夫ではなく「考え方の整理」だという点です。目的と手段をいったん分解して、「同じデータから複数の成果物を作れないか」を考えました。
試行錯誤② スキルのチューニング
構造が決まっても、毎日使えるようにするまでが本番でした。実際にはうまくいかない場面の連続で、そのたびに調整を重ねています。印象に残っている調整をいくつか紹介します。
「これだけ見れば全部分かる」と「token爆発」の綱引き
最初のダイジェストは、要点だけを抽出して載せていました。ところが使ってみると情報が足りず、「これだけ見れば全部分かる、が理想」と気づきます。では全部載せればいいかというと、今度は取得するデータが膨れ上がり、tokenを浪費してしまいました。
ここで判断軸が定まりました。「token削減と取りこぼし防止の両立」です。本文の読み込み・集計・全ソース検索のような重い処理は絞る。一方で、リンク一覧・生データ・knowledgeのような「後から自分で辿れるインデックス」は全部残す。たとえば資料は、一定のサイズまでは本文を読み込み、それを超えるものは読み込みません。ただし読んだかどうかに関わらず、全件をリンク付きで列挙するようにしました。全部読むとtokenが過多になりますが、リンクさえ残っていれば後で必要なものだけ開けます。
情報収集を「浅く」しすぎた
役割を分けようとして、情報収集(/gather)はメタデータとSlackの流し読みだけにし、踏み込んだ読み込みはリサーチ(/research)に任せる設計にしていました。ところがこれだと、gatherを見ても中身がわからず、結局その場でresearchを叩く羽目になります。
反省したのは、gatherとresearchの違いを「浅い/深い」で分けてしまったことです。本当の違いは深さではなく起点でした。gatherは『今日』を起点にその日動いた情報を漏れなく拾い、researchは『テーマ』を起点に期間を区切らず掘る。どちらも必要ならDriveやConfluenceの本文・リンク先まで深く読みます。そこでgatherにも独自に本文読み・リンク深掘りを持たせ、「情報収集は浅く済ませるものではない」と位置づけ直しました。
その他、たくさんの細かい調整
上記以外にも、日々の使い勝手のために小さな調整を積み重ねました。判断軸はどれも共通して「token削減と取りこぼし防止の両立」です。
| 論点 | 最初のAIからの案 | 実際の調整 | なぜ |
|---|---|---|---|
| Slackの差分取得 | 日付フィルタ(after:日付)で取る |
前回巡回時刻からUnix秒で差分取得 | 日単位だと前回の夜〜深夜分を取りこぼす |
| 返信ゼロのSlack | 返信のあるスレッドだけ追う | リアクション(絵文字)も取得して読む | ✅=合意・👀=見たが未対応など返信ゼロでも意思表示が完結する。「誰がボールを持っているか」を判定でき、自分の👀だけ=放置サインをTODO化できる |
| 完了したTODO | 消す | 取り消し線で残す(完了理由付き) | やったことの記録として残したい |
| 知見の書き込み基準 | ノイズになるので厳選して書く | 迷ったら書く | 後から消すほうが、書き忘れをあとで思い出すより楽 |
| クエリの粒度(bq-analysis) | クエリで集計まで済ます | BigQueryは生データの取得だけ・集計はPython | 軸を変えるたびに再クエリは非効率。同じデータで何度も試したい |
| 探索の起点(research) | テーマが来たら全ソース検索 | 先にローカル(knowledge/)を見て足りない分だけ取りに行く | 蓄積を使い回す。毎回ゼロから集めない |
チューニングは一度で終わらない —— スキル自身に「改善提案」させる
そして、チューニングは一度では終わりません。運用しながらもっとこうした方が良いをスキル自身に「改善提案」をさせることにしています。/gather は毎回の実行の最後に、3カテゴリで気づきを出します。
- A. 状況・仕事の流れへの気づき(ボトルネック・意思決定の放置・チームの負荷の偏り・自分がボールを止めている箇所、そして繰り返す手作業のスキル化の機会) 例:「◯◯さんの判断待ちが1週間経過しています。進捗はどうですか?」/「『効果試算 → 検証 → md化』を直近3回、手作業でやっています。スキル化しますか?」
- B. スキル実行の品質(取得上限・取りこぼし・スキップ・knowledge分類の迷い) 例:「Slackが取得上限の20件に達し、2ページ目が残っています。取得漏れの可能性があります」
- C. スキル・仕組みの改善(繰り返すノイズ・knowledgeの肥大化・TODOの滞留・ダイジェストの構造) 例:「TODOが3回以上繰り越されています。対応不要なら削除、期限を決めるなら明記しますか?」
3つのカテゴリは、どれもスキルを作りっぱなしにしないための仕掛けです。Bは「取りこぼしても自分では気づけない」部分を、スキル側に毎回自己点検させます。AとCは、繰り返している手作業やノイズを見つけて、次のスキルの種や改善につなげます。そもそもこの仕組みは、AIツールを「使う」ものではなく最初から「育てる」ものとして運用しているからこそ回っています。
学び
作り終えて一番強く感じたのは、次のことです。
AIに任せるには、まず自分の業務を構造化しないといけない。
この取り組みの肝は、突き詰めると3ステップでした。
- 自分が何の情報を見ているのかを洗い出す
- 何のためにそれを見ているのかを整理する
- それをAIが再現できるルールに落とし込む
結果として、AI化そのものよりも自分の業務の解像度が上がったことが大きな収穫でした。これまでこなしていた情報収集や判断を、「この6ソースのこの情報を、この目的で見ている」と構造として言語化できるようになりました。
また、ここで作った具体的な形——6つのソース、5つのスキル、個々のチューニング——が唯一の正解というわけではありません。使えるAIやツールは日々変わりますし、業務の内容やフェーズ、人それぞれのやり方や好みによっても、ちょうどいい形は変わります。
参考にしてほしいのは中身そのものよりも、「自分の業務を目的と手段に分けて構造化し、AIが再現できる形に落とし込む」という考え方のほうです。この記事の具体例も、あくまで一つのサンプルとして読んでもらえたら嬉しいです。
まとめ
- 6ソースに分散していたPdM業務を、ターミナルの中で回せるようにした(
/gather一発で取得・整理・蓄積) knowledge/に知見が自動で溜まり、AIが最初から文脈を持っている状態を作れた- 11個のやりたいことを、目的と手段の構造化で5スキルに集約した
振り返ってみると、目的と手段を分けて構造化するという作業は、AIツールの設計・活用であると同時に、要件整理やプロダクト設計とほとんど同じ営みでした。「AIツールの設計・活用は、結局やることの構造化だった」というのが、この取り組みでの一番の学びです。
最後に
バイセルでは、一緒に働くエンジニアを募集しています。興味がある方は、以下よりご応募ください。
